Fabryka AI · LLM od zera · edycja 2 · pre-sale

Zbuduj model językowy. Od tokenizera do API.

W 12 tygodni przejdziesz od danych i tokenizera do treningu, ewaluacji i własnego API. Budujesz swój projekt ze wsparciem prowadzących, TA i review kodu.

Efekty pierwszej edycji: publiczny dataset, 50+ artefaktów tokenizacji, własne modele i preprint naukowy.

14 dni na rezygnację po starcie · Zobacz rezultaty pierwszej edycji ↓

Pre-sale · LLM od zera · edycja 2

14zajętych / 15 wolnych

Pre-sale
900 zł
Docelowo
1 290 zł
Koniec
30.09.2026
Rezerwuję →

Miejsca w edycji 2. Pre-sale: 15 wolnych miejsc do 30.09.2026.

12
tygodni wspólnej pracy nad jednym modelem
14
osób w edycji 1 — wyprzedana w kilka godzin
1
własny projekt od danych do działającego API
TA
wsparcie prowadzących i review kodu

Realne research artifacts · edycja 1

Własny projekt. Publiczne rezultaty.

Kursanci zbierają dane, trenują modele, porównują wyniki i opisują wnioski. Efekty tej pracy możesz już obejrzeć: publiczny dataset, dziesiątki tokenizerów, modele, kod i wspólny preprint naukowy.

Scaling laws w praktyce · GoLLeM-v5

Własny model. Wynik, który da się sprawdzić.

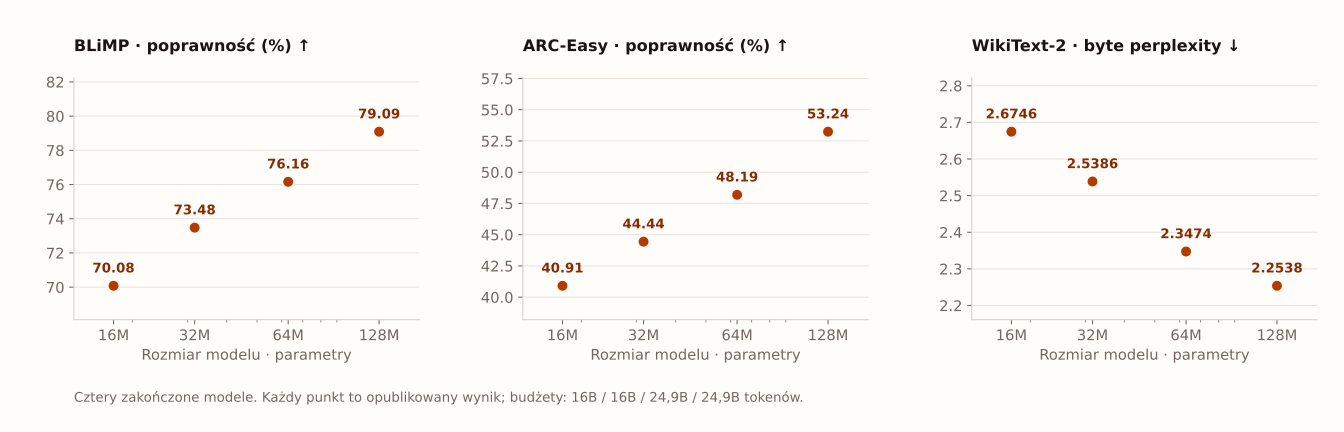
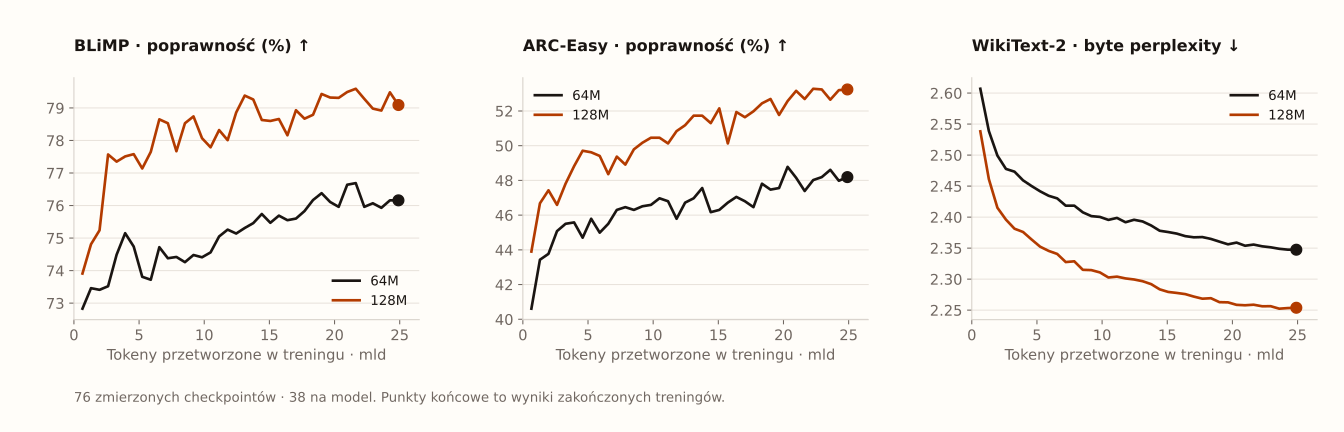
Uczysz się trenować, porównywać eksperymenty i dokumentować wyniki. Poniżej: nasze cztery angielskie modele GoLLeM i 76 publicznych pomiarów treningu.

79,09%
BLiMP · GoLLeM 128M
53,24%
ARC-Easy · GoLLeM 128M
16M → 128M
cztery rozmiary wytrenowanych modeli
76
zmierzonych checkpointów treningu 64M i 128M
GoLLeM od 16M do 128M: BLiMP wzrasta od 70,08% do 79,09%, ARC-Easy od 40,91% do 53,24%, a WikiText-2 byte perplexity spada od 2,6746 do 2,2538.
Cztery zakończone modele · wyniki z publicznych kart. Różnią się także architekturą, recepturą i budżetem tokenów; punkty pokazują obserwowany trend skalowania.

Na telefonie przesuń wykres w bok albo otwórz go w pełnym rozmiarze.

Od 16M do 128M: +12,33 pkt proc. na ARC-Easy.

Uczestnicy uczą się nie tylko uruchamiać trening, ale też wybierać eksperymenty, śledzić postęp i dokumentować wnioski. Wynik można sprawdzić w modelu, konfiguracji i pomiarach.

Wyniki końcowe i protokół pomiaru
Końcowe wyniki GoLLeM-v5 · jeden seed treningowy
ModelParametryTokeny treninguBLiMP ↑ARC-Easy ↑Byte PPL ↓
GoLLeM-v5 16M ↗17,4 mln16,0 mld70.08%40.91%2.6746
GoLLeM-v5 32M ↗31,6 mln16,0 mld73.48%44.44%2.5386
GoLLeM-v5 64M ↗62,9 mln24,9 mld76.16%48.19%2.3474
GoLLeM-v5 128M ↗122,8 mln24,9 mld79.09%53.24%2.2538

Glint-1.3: BLiMP — 67 000 par; ARC-Easy — 2 376 pytań; WikiText-2 — zbiór testowy. To zapisane pomiary autorów, bez ekstrapolacji na większe modele. Krzywe pokazują postęp, a nie dopasowane uniwersalne prawo potęgowe.

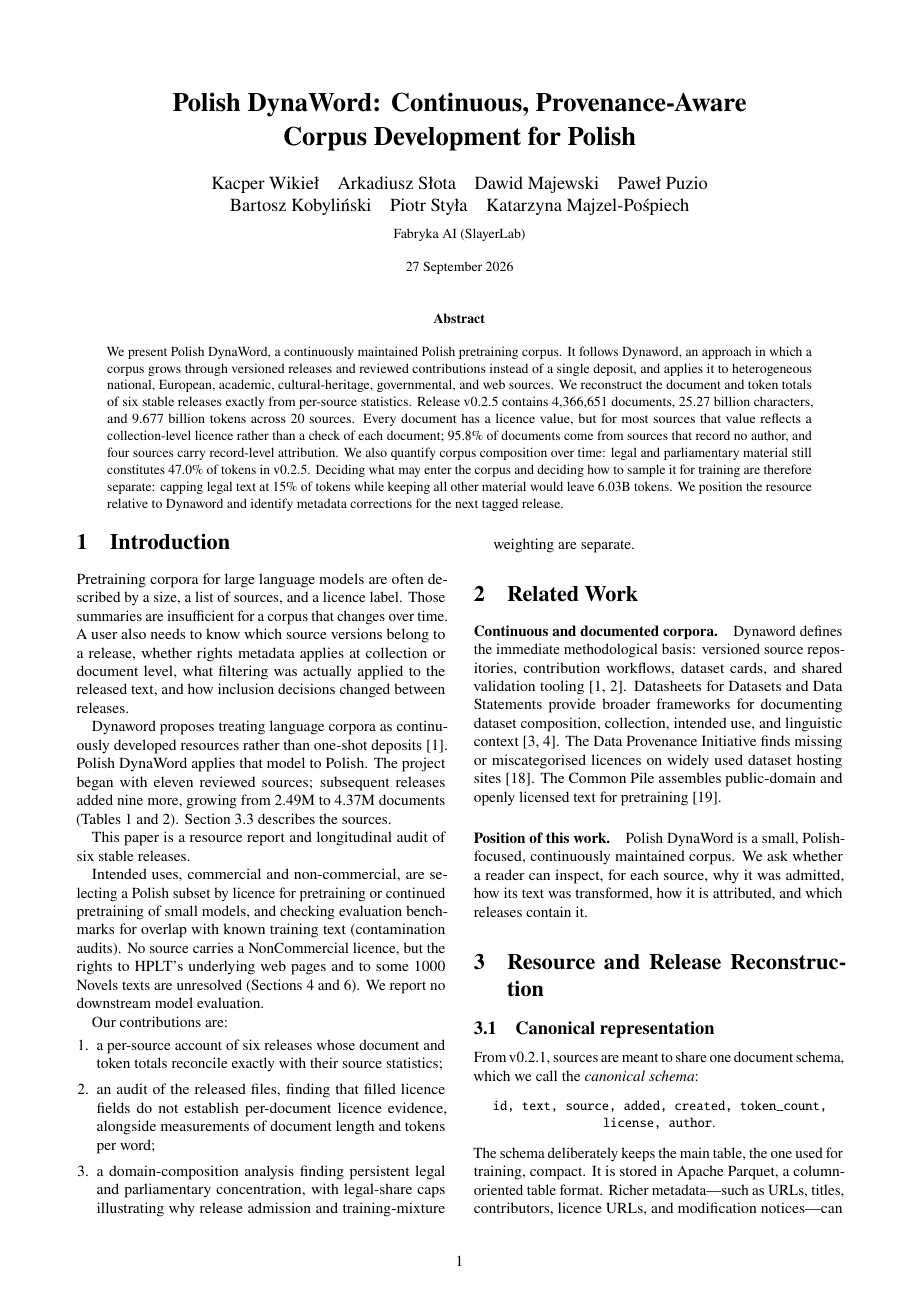
Pierwsza strona preprintu Polish DynaWord z nazwiskami siedmiu współautorów

Artykuł naukowy Preprint · WIP

Polish DynaWord

Continuous, Provenance-Aware Corpus Development for Polish

Wspólna praca prowadzącego i kursantów: rozwój korpusu, audyt danych, analiza sześciu wydań i opis wyników w artykule naukowym.

Kacper Wikieł, Arkadiusz Słota, Dawid Majewski, Paweł Puzio, Bartosz Kobyliński, Piotr Styła, Katarzyna Majzel-Pośpiech.

Preprint w trakcie prac (work in progress), przed recenzją naukową. Pokazujemy aktualny rezultat wspólnego projektu.

Czytaj preprint · PDF ↗

Publiczny dataset · tysiące pobrań

Polish DynaWord

Współtworzony przez kursantów polski korpus do treningu modeli językowych. Publiczne wydania, wkłady autorów i dokumentacja na Hugging Face.

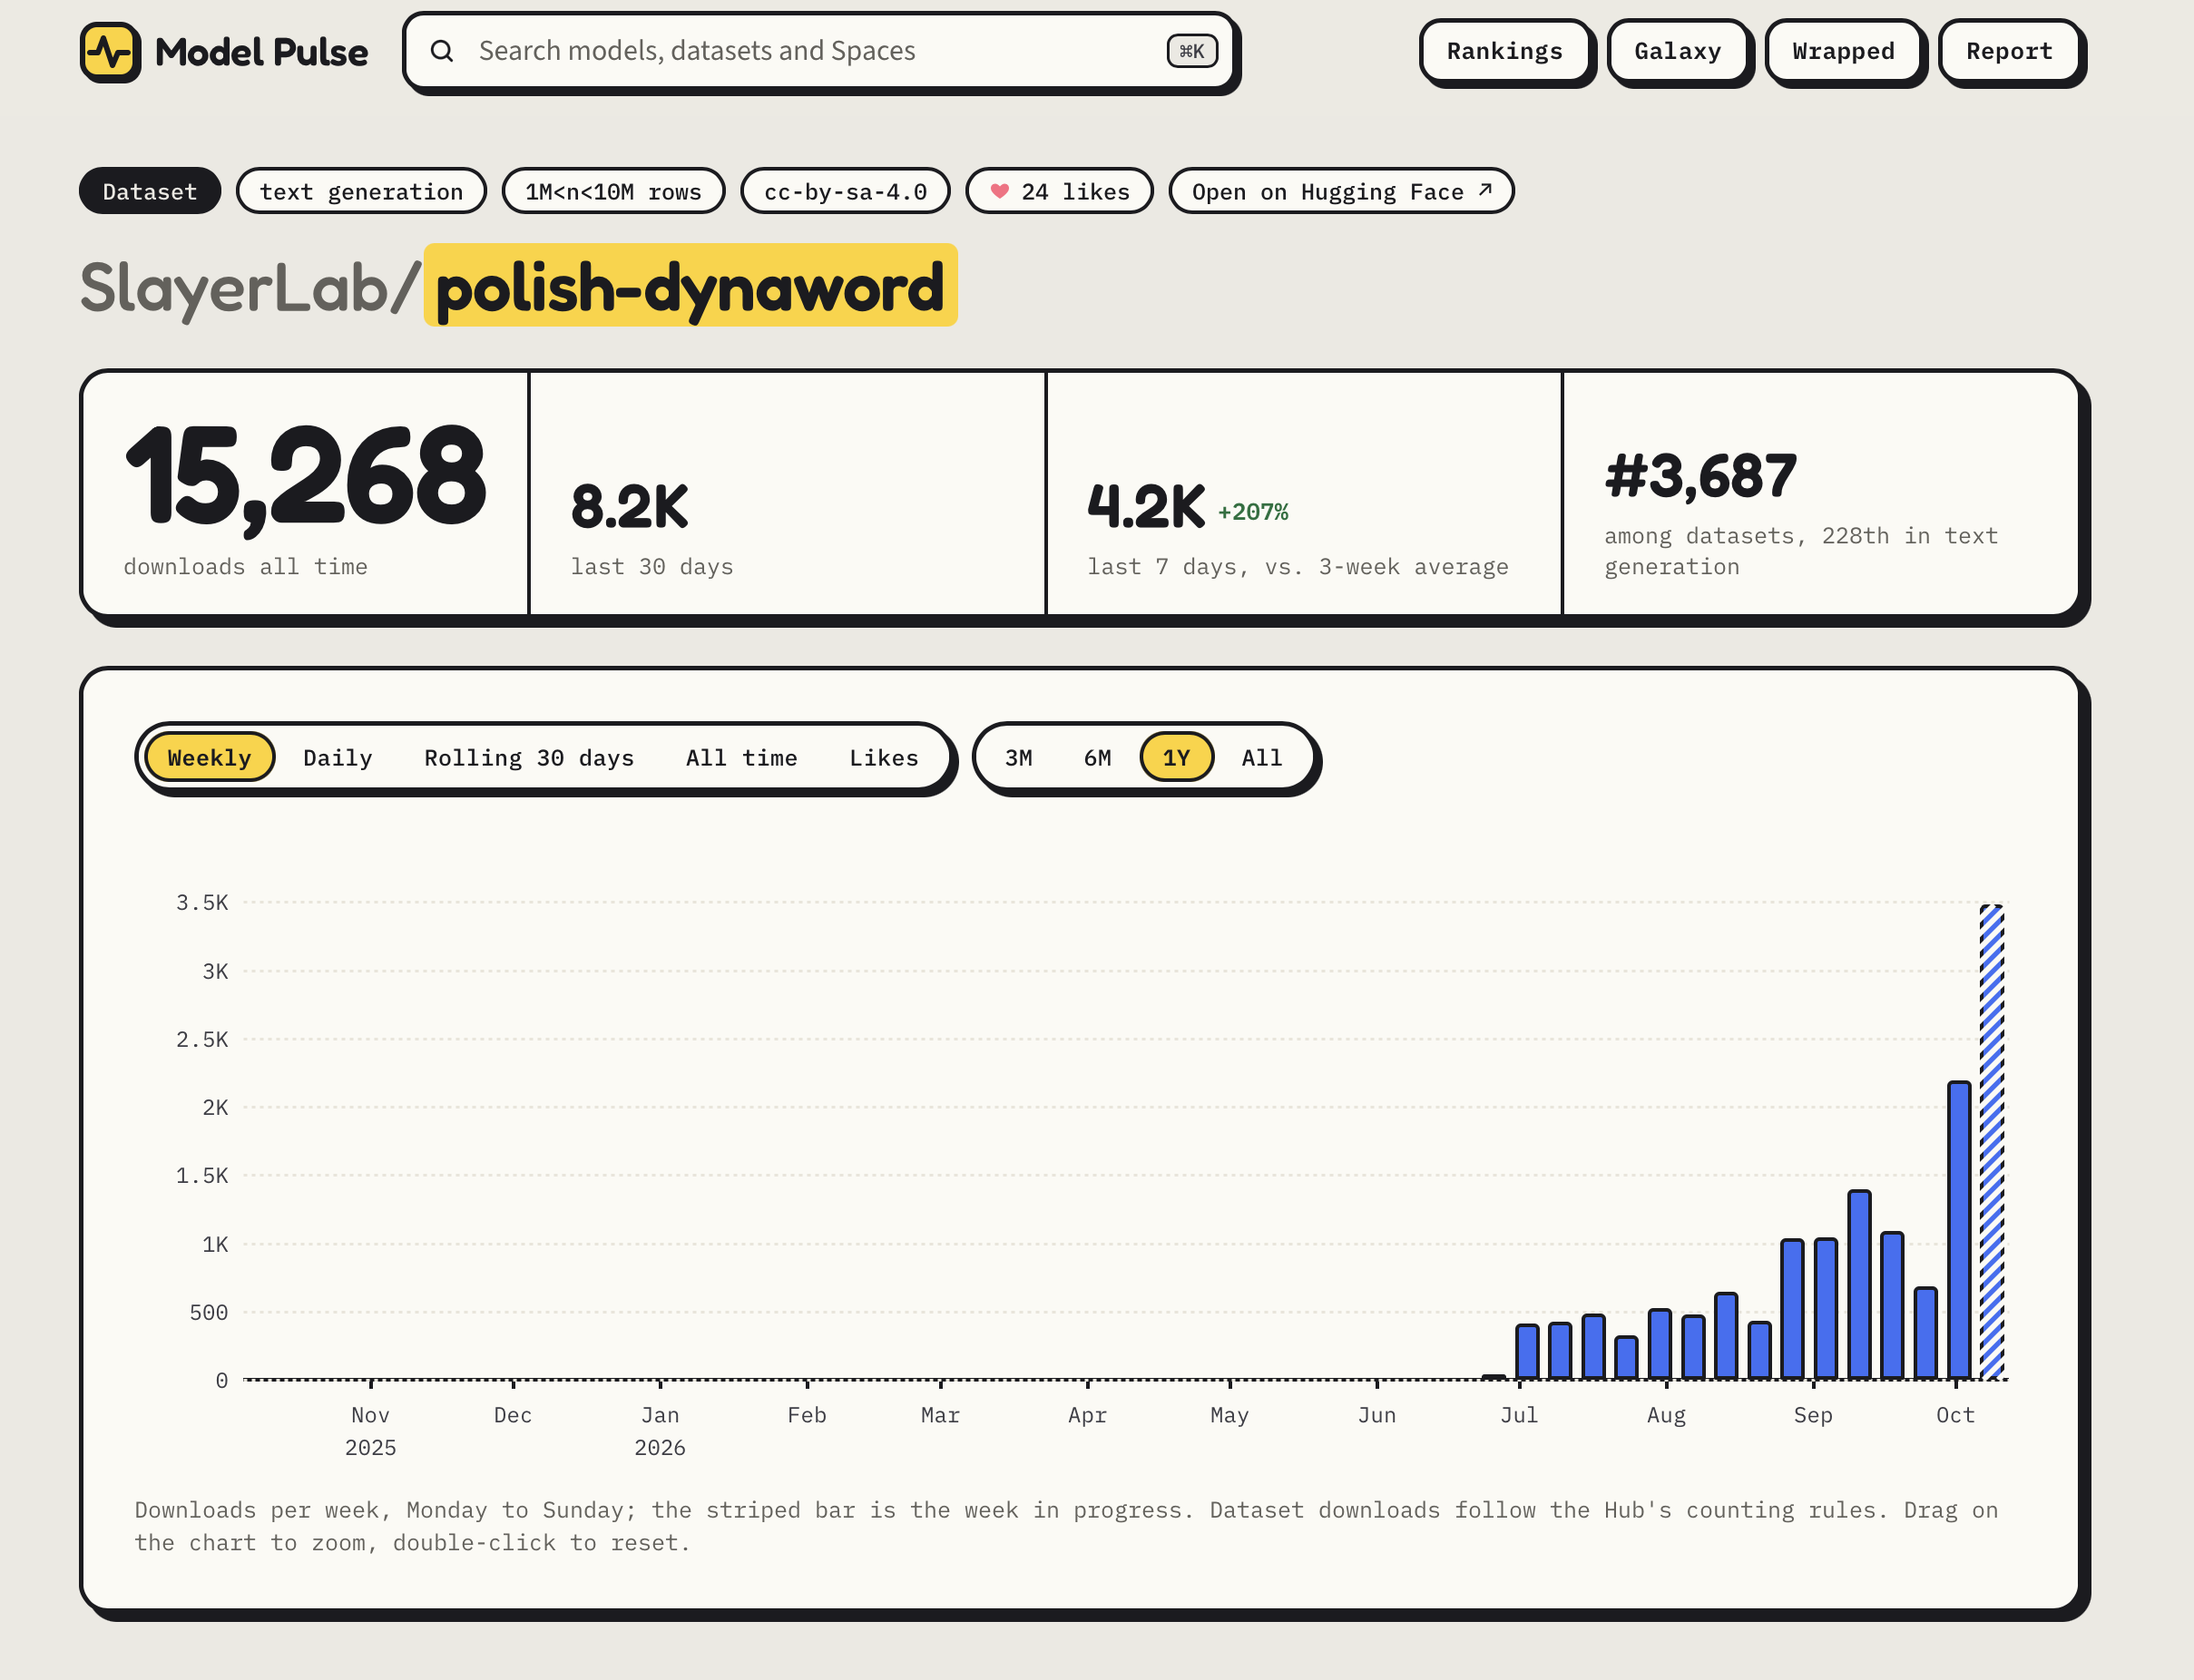
15 268 pobrań łącznie według Model Pulse

8,2 tys.
pobrań w 30 dni
4,2 tys.
pobrań w 7 dni
+207%
wobec średniej z poprzednich 3 tygodni

Model Pulse · stan ze zrzutu 09.10.2026 · zobacz wykres ↓

Wydanie v0.2.5: 9,68 mld tokenów proxy · 4,37 mln dokumentów · 20 źródeł.

Poznaj współtwórców i ich wkład ↓ Zobacz publiczny dataset ↗

Tokenizery z zajęć · publiczne prace uczestników

Pierwszy temat. Dziesiątki własnych artefaktów.

Już przy tokenizacji uczestnicy przechodzą pełny cykl badawczy: implementacja BPE, trening na polskich tekstach, porównanie wariantów i opis wniosków. Powstało wspólne repo z tokenizerami, raportami, kodem i wizualizacjami.

50+
opublikowanych artefaktów tokenizacji
12
katalogów prac uczestników
512 tys.
tokenów w największym zapisanym słowniku

Stan repozytorium: 09.10.2026 · spis policzonych artefaktów ↗

12 autorów · jeden projekt na osobę

Wszystkie prace uczestników.

Każda osoba ma tutaj swój projekt. Rozwiń kartę, aby obejrzeć wszystkie zapisane warianty, słowniki lub opracowania. Rankingi poniżej pokazują te wyniki, które zmierzono na wspólnym zestawie danych.

Arek ↗

17 zapisanych artefaktów

Zobacz prace (17)

Dawid ↗

8 zapisanych artefaktów

Zobacz prace (8)

Paweł Puzio ↗

10 zapisanych artefaktów

Zobacz prace (10)

Leaderboard · wyniki z repozytorium uczestników

Jak wypadają tokenizery kursantów?

Fertility to liczba tokenów na słowo. Im mniej, tym krótsza reprezentacja tekstu. Wybierz zestaw pomiarowy i porównaj tokenizery na tych samych danych. Pokazujemy najlepszy wynik każdej osoby; zmiana limitu słownika wybiera najlepszy wariant spełniający ten limit.

Najniższa fertility w tym pomiarze1,4988dynaword-128k-g220mb-l50mb · Paweł Puzio

48 354 dokumenty · wydzielone końcówki 12 źródeł DynaWord

2 pozycje · najlepszy wynik każdej osoby

DynaWord · ranking w obrębie jednego zestawu pomiarowego
#TokenizerAutorSłownikTokenów / słowo ↓
1dynaword-128k-g220mb-l50mb ↗Paweł Puzio128 0001.4988
2kuba-14k ↗Kuba14 0002.1498

Ranking dotyczy wybranego zestawu danych. Wyniki DynaWord i HPLT mają różne protokoły, więc nie tworzą wspólnej klasyfikacji. Większy słownik może skracać tekst, ale zwiększa rozmiar modelu. To opublikowane pomiary autorów.

Źródło pomiarów ↗ · stan 09.10.2026 · pobierz dane leaderboardu ↗

Zainteresowanie publicznym datasetem

Tysiące pobrań. Rosnące zainteresowanie.

Współtworzony przez kursantów Polish DynaWord ma już ponad 15 tys. pobrań. Model Pulse pokazuje, jak zainteresowanie datasetem rośnie z tygodnia na tydzień.

Model Pulse, Polish DynaWord: 15 268 pobrań łącznie, 8,2 tys. w 30 dni, 4,2 tys. w 7 dni, wzrost o 207% względem średniej z poprzednich trzech tygodni. Wykres tygodniowych pobrań rośnie od lipca do października 2026.

Źródło: Model Pulse ↗ · zrzut z 09.10.2026. Ostatni kreskowany słupek obejmuje niepełny tydzień. Liczniki oznaczają pobrania według zasad Hugging Face.

Publiczne wkłady · autorzy, dane i review

DynaWord ma konkretnych współtwórców.

Za datasetem stoją ludzie, którzy pozyskują źródła, budują pipeline’y, opisują dane i przechodzą review. Każdy wkład poniżej prowadzi do autora i publicznych zgłoszeń na Hugging Face.

9 współtwórców w karcie datasetu112 zamkniętych zgłoszeńZobacz historię pracy ↗

Wkład w v0.2.3

1am ↗

NKJP1M

Pozyskanie korpusu, pipeline budowy, dokumentacja i artefakt danych.

Prowadzący / maintainer

Kacper Wikieł ↗

Prowadzenie i utrzymanie projektu

Przegląd źródeł, dokumentacja, walidacja, wydania i odtwarzalna budowa korpusu.

Pozostałe zgłoszenia i status prac

Konrad Talik zgłosił SJP.PL (#6). Zgłoszenie ma status merged, ale nie wykazuje wynikowego artefaktu danych, dlatego karta datasetu nie zalicza go do wkładów danych.

Zamknięcie zgłoszenia nie zawsze oznacza wydanie danych. Wkłady z #19 i #15 trafiły na main przez #44 i #46. Nowe prace na main pokazujemy osobno od wydania v0.2.5.

Źródła: karta datasetu ↗ i pełna historia dyskusji · sprawdzono 09.10.2026 · spis publicznych zgłoszeń ↗

Chcesz przejść tę drogę? W edycji 2 budujesz własny projekt ze wsparciem prowadzących i grupy.

Dołącz do edycji 2 →

01 · edycja 1 → 2

Druga edycja. Więcej praktyki i wsparcia.

W drugiej edycji przechodzisz cały proces budowy modelu z pomocą prowadzących i TA. Pracujesz nad własnym repo, otrzymujesz review kodu i spotykasz się z grupą podczas sobotnich warsztatów.

01Własny model od początku do końca

Przechodzisz przez dane, tokenizer, trening, ewaluację i API. Budujesz własne repo i uczysz się podejmować decyzje na każdym etapie.

02TA z alumnów edycji 1

Twoje repo czyta ktoś, kto trzy miesiące temu przeszedł tę samą drogę i pamięta, gdzie się wywraca loss.

03Społeczność kursu

Discord kohorty to miejsce na pytania, dyskusje i wymianę doświadczeń podczas pracy nad własnym modelem.

04Soboty warsztatowe

Długie sesje na trening i debugowanie, nie tylko wieczory po pracy.

05Wspólny artykuł

Zobacz preprint Polish DynaWord współtworzony przez kursantów edycji 1. W edycji 2 rozwijamy to samo podejście: eksperymenty, pomiary i wspólne opracowanie wyników.

Kto prowadzi

Kacper Wikieł

Buduje dane pretreningowe, tokenizery i pipeline'y ewaluacji dla polskich i niskozasobowych modeli w SlayerLab (Fabryka AI). Wcześniej ML Engineer w PwC, ML/CV Engineer u krajowego operatora infrastruktury przesyłowej i Software Engineer od generatywnego AI w Procter & Gamble. Autor Polish DynaWord, CodeSOTA i Hardparse. O polskich modelach mówił w TVN24.

Rys. 02 · Polish DynaWord · wydania v0.2.0–v0.2.5
10 mld 0 v0.2.0 v0.2.1 v0.2.2 v0.2.3 v0.2.4 v0.2.5 9,68 mld
20
źródeł w wydaniu v0.2.5
4,37 mln
dokumentów w wydaniu v0.2.5
9
współtwórców w karcie datasetu
v0.2.5
wersjonowane dane i dokumentacja źródeł

Polski wariant frameworku Dynaword (Enevoldsen i in., 2025): każde źródło ma osobny datasheet i jawnie wykluczone kandydatury, a nie sam zrzut bajtów. Wspólny artykuł prowadzącego i kursantów jest dostępny jako preprint · WIP ↗.

Głos z Akademii

Opinia kursanta.

„Otwartość na wiedzę, pomoc oraz "otwarte myślenie" sprawiło że zostałem tutaj na dłużej.”

Kursant Akademii · autor modeli GoLLeM
Przeczytaj pełną opinię

Akademia jest to inicjatywa zbudowana na fundamentach otwartości do wiedzy. W pierwszych dniach gdy usłyszałem o inicjatywie i dowiedziałem się że jest możliwość, że ktoś zaprasza losowo ludzi aby pokazali co potrafią, stwierdziłem że muszę zobaczyć czy to PRAWDA. Okazało się że jest lepiej niż przypuszczałem. Otwartość na wiedzę, pomoc oraz "otwarte myślenie" sprawiło że zostałem tutaj na dłużej. Przed akademią już dostałem wsparcie merytoryczne w ramach swoich "prac", więc miałem małe intro co będzie na samej akademii..

Okazało się jednak, że szkolenie miało zupełnie inny format niż przypuszczałem: Zajęcia rozpoczynamy od podstaw, czyli od tego jak podchodzi do procesów badawczych. Cały kurs przygotowuje mentalnie, do tego, jak powinny być prowadzone badania naukowe. Wysoko zaskakujące jest jak ten aspekt, potrafi znacząco wpłynąć na umiejętności percepcyjne.

Tematyka pierwszych zajęć jednak dotyczyła "mistycznego" Tokenizera. Dostaliśmy zarys, informację gdzie patrzeć, jak badać i że końcowo, po tygodniu, mamy dostarczyć nasze własne tokenizery. Okazało się że mix wszystkich powyższych rzeczy już na tym etapie, w pewnym sensie nauczył nas podejścia naukowego. Umiejętne wyszukiwania informacji i wykorzystywanie narzędzi + teoria. Końcowo skończyło się na wspólnym repo z dużą ilością tokenizerów w przedziale vocabsize 600-255k (idealne pole do eksperymentów!)

Następne tygodnie mijały nam podobnie jak pierwszy tydzień, lecz tematyka się zmieniała. Przechodziliśmy przez sposób podejścia, aż do zamknięcia danego tematu artefaktem. Stworzyliśmy własne datasety, dodaliśmy zbiory do naszego Dynaword, piszemy papier naukowy o tym.

Mam na koncie już kilka modeli GoLLeM które robią mniejsze lub większe wrażenie. Kilka z nich nawet zajęły (wyższe)miejsca w tabelach dla małych modeli do 150m. Ostatni GoLLeM v5 125m zajął 4 miejsce w klasyfikacji Glint-Leaderboard na skali OverALL. Jestem właśnie w trakcie budowy interaktywnego chata dla mojego GoLLeMa v6 na track.fabryce(nasza strona/api(?) gdzie każdy może stworzyć sobie mały model LLM). Następnie przechodzę branding z GoLLeM na Slayer z rodziną modeli i widzimy się na pierwszym miejscu w https://huggingface.co/spaces/Glint-Research/Tiny-ML-Leaderboard ↗
02 · Slayer Lab

Kurs dla Ciebie. Rozwój laboratorium.

Kupując kurs, wspierasz rozwój Slayer Lab, w tym zakup NVIDIA DGX Spark.

03 · rezultat

Nie oglądasz budowy modelu. Zostawiasz repo, które działa.

Program prowadzi przez cały łańcuch pracy. Rezultatem nie jest certyfikat, lecz kod, decyzje, pomiary i model, który potrafisz wyjaśnić.

01

Tokenizer i dane

Własny tokenizer BPE, pipeline czyszczenia, podział danych oraz raport jakości.

02

Model bazowy

Mały GPT napisany i wytrenowany od podstaw, z manifestem konfiguracji i checkpointami.

03

Ewaluacja

Held-out loss, próbki generacji i mini-benchmark z opisanym protokołem oraz ograniczeniami.

04

Wdrożenie

Dostrojenie, kwantyzacja i lokalne API z pomiarem szybkości oraz kosztu inferencji.

04 · program

Jeden model. Pięć warstw pracy.

Każdy tydzień rozwija ten sam projekt. Kliknij moduł, aby zobaczyć temat i artefakt końcowy.

Blok IFundamenty
01TokenizerBPE · polszczyzna

Byte-level BPE, kompresja i pułapki polskiej morfologii.

Artefakt: własny tokenizer i raport porównawczy.
02Danejakość · deduplikacja

Źródła, licencje, filtrowanie jakości, MinHash/LSH, PII i deterministyczne splity.

Artefakt: pipeline danych z manifestem pochodzenia.
03Język jako prawdopodobieństwobigram · MLP

Od zliczeń do sieci, embeddingi, backprop i negative log likelihood.

Artefakt: bigram i MLP generujące pierwsze próbki.
Blok IITransformer
04AttentionQ · K · V

Self-attention krok po kroku, maska przyczynowa, multi-head i pozycje.

Artefakt: single-head attention bez gotowego modułu.
05Pełna architektura GPTresidual · norm · MLP

Bloki transformera, pre-norm, RMSNorm, SwiGLU, GQA i świadome decyzje architektoniczne.

Artefakt: model robiący pełny forward pass.
06Treningoptymalizacja · debug

Batching, AdamW, harmonogram LR, mixed precision, checkpointing i diagnostyka lossa. Pierwszy dłuższy eksperyment treningowy.

Artefakt: wytrenowany checkpoint i karta przebiegu.
Blok IIISkala i pomiar
07Skalowaniecompute · DDP

Scaling laws, budżet tokenów, multi-GPU i ekonomia treningu.

Artefakt: policzony plan większego eksperymentu.
08Ewaluacjaprotokół · PL

Held-out loss, zadania downstream, benchmarki polskie i ryzyko kontaminacji.

Artefakt: własny mały benchmark z kartą metodologiczną.
Blok IVOd base do instruct
09SFT, LoRA i QLoRAdostrajanie

Dane instrukcyjne, chat templates i adaptacja niskiego rzędu.

Artefakt: porównanie modelu przed i po dostrojeniu.
10Preferencje i DPOalignment

Dane preferencyjne, funkcja celu DPO i typowe błędy alignowania małych modeli.

Artefakt: kontrolowany eksperyment DPO.
Blok VProdukcja
11InferencjaGGUF · API

KV-cache, batching, kwantyzacja, llama.cpp i pomiar tokenów na sekundę.

Artefakt: lokalne API z benchmarkiem wydajności.
12Capstonedemo · publikacja

Projekt end-to-end: dane, trening lub dostrojenie, ewaluacja i wdrożenie. Wspólny artykuł kohorty.

Artefakt: demo projektu i dokumentacja decyzji.

05 · metoda

Rygor bez marketingowych procentów.

Nie obiecujemy wyniku bez pomiaru. Ustalamy rytm, kryteria artefaktu i sposób review, a postęp jest widoczny w kodzie.

Co tydzień

Teoria → praktyka → artefakt

Zajęcia porządkują temat, sobota warsztatowa uruchamia większy eksperyment, a zadanie kończy się sprawdzalnym plikiem, kodem lub wynikiem.

Review

Człowiek czyta decyzje

Liczy się nie tylko to, czy kod działa. Opisujesz założenia, porównujesz warianty i bronisz wniosków na podstawie pomiaru. Czyta TA z edycji 1 i Kacper.

Pamięć projektu

Manifesty zamiast magii

Źródła danych, konfiguracje, checkpointy, metryki i ograniczenia pozostają w repo. Da się odtworzyć drogę do wyniku.

06 · cena

Dołącz w pre-sale. 900 zł za pełny program.

W cenie masz pełny program, wsparcie TA, review kodu i soboty warsztatowe. Pre-sale to niższa cena za wcześniejszy zapis. Ceny są końcowe, faktura na firmę na życzenie.

Edycja 2 · pre-sale · 15 wolnych miejsc · do 30.09.2026

Kurs w pre-sale

900 zł

  • 12 tygodni budowania własnego modelu
  • Soboty warsztatowe
  • Review kodu przez TA i Kacpra
  • Nagrania i Discord kohorty
Rezerwuję za 900 zł →
Edycja 2 · cena docelowa

Po pre-sale

1 290 zł

  • Ten sam pełny program kursu
  • Soboty warsztatowe
  • Review kodu przez TA i Kacpra
  • Nagrania i Discord kohorty

W cenie kursu w edycji 2: 12 tygodni zajęć, soboty warsztatowe, review TA i Kacpra, nagrania, Discord kohorty, faktura na firmę na życzenie.

Gwarancja

Kurs się odbywa. Masz 14 dni na rezygnację po starcie. Jeden mail wystarczy.

07 · rezerwacja lub zakup

Porozmawiajmy albo dołącz od razu.

Kupuję od razu · 900 zł

Wiesz już, że chcesz dołączyć? Przejdź do płatności za drugą edycję w pre-sale.

Kupuję kurs →

Sprawdźmy, czy to dla Ciebie.

Zostaw imię, e-mail i telefon. Zadzwonię, porozmawiamy o Twoim doświadczeniu i celach oraz sprawdzimy, czy kurs jest dobrym pomysłem na tym etapie. Samo zgłoszenie nie zobowiązuje do zakupu.

Kwota
900 zł, cena końcowa; płatność linkiem EasyTools
Telefon
zadzwonię, żeby omówić kurs i odpowiedzieć na Twoje pytania
Start
Listopad 2026, termin potwierdzony po pre-sale
Faktura
Na firmę, odpisz z NIP-em

Zarezerwuj miejsce i zostaw dane

Najpierw rozmowa. Decyzję o zakupie podejmiesz po niej.

Bez newslettera. Dane służą wyłącznie do obsługi rezerwacji i faktury.

08 · dla kogo

Ambitny start. Jasne wymagania.

To ma sens, jeśli

  • znasz podstawy Pythona;
  • chcesz rozumieć modele, nie tylko wywoływać API;
  • możesz pracować systematycznie nad jednym repo;
  • interesuje cię polski język, open source i research.

To nie jest dobry moment, jeśli

  • szukasz krótkiego kursu promptowania;
  • nie chcesz pisać ani czytać kodu;
  • nie masz czasu na regularną pracę własną;
  • potrzebujesz gwarantowanego wyniku bez eksperymentów.

10 · FAQ

Zanim zarezerwujesz.

Dlaczego telefon jest obowiązkowy?

W formularzu rozmowy proszę o telefon, żebym mógł zadzwonić i wspólnie z Tobą sprawdzić, czy kurs odpowiada Twoim celom. Jeśli chcesz od razu kupić kurs, wybierz „Kupuję kurs” w sekcji rezerwacji.

Co obejmuje cena kursu?

Pełny 12-tygodniowy program, wsparcie prowadzących i TA, review kodu, soboty warsztatowe, nagrania i Discord kohorty. Cena pre-sale to 900 zł, a docelowa — 1 290 zł.

Kiedy start edycji 2?

Listopad 2026. Dokładny termin potwierdzam mailem uczestnikom po zamknięciu pre-sale.

Jaki sprzęt przygotować do kursu?

Przygotuj komputer do pisania kodu. Wymagania środowiska i sposób uruchamiania eksperymentów omówimy przed startem. Możemy też porozmawiać o Twoim sprzęcie podczas rozmowy przed zapisem.

Czy jest limit miejsc?

14 miejsc w edycji 2 jest zajętych. W pre-sale zostało 15 wolnych miejsc po 900 zł, dostępnych do 30.09.2026.

Czy kurs się odbędzie i czy mogę zrezygnować?

Kurs się odbywa. Masz 14 dni na rezygnację po starcie. Wystarczy jeden mail.

Ile muszę umieć na starcie?

Podstawy Pythona i gotowość do matematyki na poziomie licealnym. PyTorch i transformatory budujemy krok po kroku.

Ile czasu potrzeba tygodniowo?

Zajęcia w tygodniu, sobota warsztatowa i regularna praca własna nad repo. Realny zakres godzin potwierdzam przy rozmowie, zależnie od punktu startowego.

Czy dostanę fakturę?

Tak, na firmę. 900 zł to cena końcowa. Po rezerwacji odpisz na maila z NIP-em, a fakturę dostaniesz przez EasyTools razem z linkiem do płatności.

Co dokładnie zostaje po programie?

Repo projektu, tokenizer, konfiguracje, checkpointy, wyniki ewaluacji, dokumentacja decyzji, działające demo projektu i wspólny artykuł kohorty.